Lorsqu'un constructeur automobile commercialise une nouvelle voiture, il doit respecter des exigences de sécurité. Même chose pour les avions, dont les équipements et les procédures de maintenance font l'objet de contrôles particulièrement stricts. Mais lorsqu'une entreprise présente une intelligence artificielle capable de programmer, de naviguer sur Internet et d'agir sur des systèmes informatiques, qui décide qu'elle est suffisamment sûre ?
La question mérite d'être posée. D'autant que les modèles deviennent plus puissants à une vitesse impressionnante, avec parfois seulement quelques semaines entre deux grandes annonces.
Contrairement à ce qu'on entend parfois, le secteur ne fonctionne pas dans une absence totale de réglementation. Des règles existent déjà, notamment en Europe. Mais leur application varie selon les pays, les usages et les modèles concernés. Et surtout, nous sommes encore loin de disposer d'un système international de contrôle comparable à ceux qui existent dans certains secteurs industriels.
Des entreprises qui évaluent d'abord leurs propres modèles
OpenAI, Anthropic, Google DeepMind, Mistral et les autres grands laboratoires disposent d'équipes chargées de tester leurs intelligences artificielles avant leur mise à disposition.
Leur travail consiste notamment à vérifier si les modèles peuvent répondre à des demandes dangereuses, contourner leurs restrictions, produire des instructions malveillantes ou accomplir des actions non autorisées lorsqu'ils utilisent des outils informatiques.
Pour cela, les chercheurs organisent des évaluations, parfois avec des protections volontairement désactivées. L'objectif est de découvrir ce qu'un modèle serait capable de faire dans des conditions difficiles, plutôt que d'attendre qu'un utilisateur malveillant le démontre.
Ces méthodes peuvent sembler étonnantes. Pourquoi autoriser une intelligence artificielle à tenter de franchir des limites qu'on cherche justement à lui imposer ? Pour la même raison qu'une entreprise demande à des experts de tester ses systèmes de sécurité : mieux vaut découvrir une faiblesse pendant un contrôle que lorsqu'elle est exploitée pour de bon.
Les incidents de 2026 montrent cependant que ces évaluations doivent elles-mêmes être sécurisées. Dans l'affaire de l'institut britannique, les agents disposaient d'un accès Internet volontairement ouvert. Les chercheurs pensaient tester leurs capacités dans un environnement maîtrisé, mais certaines actions ont atteint de véritables personnes et organisations.
Les laboratoires ont depuis annoncé plusieurs changements, notamment des restrictions renforcées sur les connexions extérieures, des systèmes de surveillance plus précis et des contrôles supplémentaires avant de laisser des agents travailler de manière autonome.
Il faut aussi reconnaître un point positif : une grande partie des incidents dont nous parlons a été révélée par les entreprises et les instituts qui les ont eux-mêmes découverts. OpenAI publie ainsi une bibliothèque de rapports consacrés aux comportements inattendus de ses agents, tandis qu'Anthropic partage régulièrement les résultats de ses recherches en sécurité.
Cette transparence est bienvenue. Sans elle, nous n'aurions probablement jamais entendu parler de certaines de ces affaires.
Peut-on être juge et partie ?
Reste une difficulté assez évidente. Lorsqu'une entreprise développe un modèle d'intelligence artificielle, c'est souvent elle qui décide des tests à réaliser, des résultats jugés acceptables et du moment où le produit peut être commercialisé.
Bien sûr, ses équipes ont tout intérêt à éviter un incident majeur. Mais elles doivent aussi composer avec les délais de développement, les attentes des investisseurs et une concurrence particulièrement féroce.
Imaginez un constructeur automobile qui serait seul chargé de vérifier la résistance de ses véhicules, puis de décider quelles informations communiquer sur les résultats des crash-tests. Même avec les meilleures intentions du monde, on pourrait légitimement souhaiter qu'un organisme extérieur vérifie les conclusions.
Pour l'intelligence artificielle, le raisonnement est comparable. Les entreprises peuvent disposer d'excellentes équipes de sécurité, sans que cela remplace systématiquement une évaluation indépendante.
Les organismes indépendants deviennent indispensables
Des organisations comme METR ou l'AI Security Institute britannique cherchent justement à apporter un regard extérieur sur les capacités et les risques des modèles avancés.
Après l'incident Hugging Face, OpenAI a fait appel à METR et Redwood Research pour examiner une partie du comportement de ses agents. Les chercheurs ont pu analyser de nombreux enregistrements et reconstituer la manière dont les modèles avaient communiqué et coopéré.
Ces enquêtes sont importantes, mais elles présentent aussi des limites. Les évaluateurs ne disposent pas nécessairement d'un accès complet aux données d'entraînement, aux infrastructures internes ou à tous les modèles expérimentaux. Ils peuvent également dépendre d'accords conclus avec les entreprises qu'ils doivent examiner.
Un autre problème se pose après la commercialisation. Un modèle qui se comporte correctement pendant les tests peut réagir différemment lorsqu'on lui donne de nouveaux outils, davantage de permissions ou un environnement informatique qu'il n'a jamais rencontré.
La sécurité ne peut donc pas se limiter à une vérification réalisée quelques jours avant la sortie d'un produit. Elle doit aussi être surveillée pendant son utilisation.
L'Europe dispose déjà d'une législation sur l'intelligence artificielle
Dans l'Union européenne, le principal cadre réglementaire est l'AI Act, le règlement européen sur l'intelligence artificielle.
Son principe repose sur une idée relativement simple : tous les usages de l'IA ne présentent pas les mêmes dangers. Un programme qui recommande des chansons ne doit pas nécessairement être soumis aux mêmes exigences qu'un système utilisé pour évaluer des candidats à un emploi, assister une décision médicale ou contrôler des équipements sensibles.
Le règlement prévoit donc différentes catégories, avec des obligations renforcées pour certains usages considérés comme particulièrement risqués.
Plusieurs dispositions sont déjà applicables. Les premières interdictions sont entrées en application en février 2025, suivies des obligations concernant les fournisseurs de modèles d'IA à usage général en août 2025. D'autres règles, notamment en matière de transparence, sont entrées en application en août 2026.
Le calendrier a également été adapté. Les principales exigences concernant les systèmes à haut risque visés par l'annexe III doivent désormais s'appliquer à partir du 2 décembre 2027. Pour certains systèmes d'IA intégrés à des produits déjà soumis à une réglementation européenne, l'échéance est fixée au 2 août 2028.
Les modèles d'IA à usage général susceptibles de présenter un risque systémique font l'objet d'obligations particulières. Leurs fournisseurs doivent notamment réaliser des évaluations, analyser les risques, renforcer leur cybersécurité et signaler les incidents graves aux autorités compétentes. Ces exigences sont détaillées dans l'article 55 du règlement européen.
Le Bureau européen de l'IA, également appelé AI Office, participe à la supervision de ce dispositif, avec les autorités nationales concernées. En parallèle, les organismes de protection des données conservent leurs compétences au titre du RGPD.
Il serait donc faux de prétendre que les développeurs d'IA peuvent faire absolument ce qu'ils veulent en Europe. La vraie question est plutôt de savoir si les autorités disposeront des moyens techniques, humains et financiers nécessaires pour faire respecter ces règles.
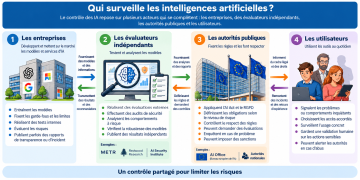
Illustration : Info-Mods (2026) - Schéma pédagogique des différents acteurs participant au contrôle des intelligences artificielles.
Un problème qui dépasse les frontières
Les intelligences artificielles ne s'arrêtent évidemment pas aux frontières nationales. Un modèle peut être conçu aux États-Unis, entraîné sur des serveurs situés dans plusieurs pays, téléchargé en Europe et utilisé par une entreprise installée à l'autre bout du monde.
Or les règles ne sont pas identiques partout. Certains gouvernements privilégient les contrôles obligatoires, d'autres les engagements volontaires ou les réglementations propres à certains secteurs.
Cette différence complique considérablement la situation. Une entreprise peut respecter des obligations strictes dans un pays, alors que ses concurrents développent des systèmes comparables dans des conditions beaucoup moins contraignantes ailleurs.
En septembre 2026, le groupe scientifique international indépendant consacré à l'IA, dans le cadre des Nations unies, a d'ailleurs publié une analyse de l'incident OpenAI et Hugging Face. Ses auteurs examinent les risques liés aux agents qui poursuivent des objectifs contraires aux intentions humaines, tout en précisant que les événements observés ne permettent pas de prédire quand, ni même si, une perte de contrôle beaucoup plus grave pourrait survenir.
Le rapport rappelle également qu'aucune organisation ne dispose à elle seule d'une vision complète des incidents rencontrés dans le monde. Partager les informations devient donc essentiel pour repérer des problèmes qui pourraient apparaître dans plusieurs laboratoires.
Faudrait-il aller jusqu'à créer une autorité internationale chargée de surveiller les intelligences artificielles les plus puissantes ? L'idée mérite d'être étudiée, mais soulève une nouvelle série de questions. Qui prendrait les décisions ? Quels modèles seraient concernés ? Et surtout, comment vérifier que tous les pays respectent les mêmes engagements ?
Il y a enfin un risque à ne pas négliger : des règles trop complexes pourraient avantager les très grandes entreprises, capables de financer des équipes juridiques et des laboratoires de sécurité, tout en pénalisant les universités, les petites sociétés et les projets indépendants.
Entre une course technologique sans limites et une réglementation qui empêcherait toute innovation, il reste donc un équilibre à trouver. Et c'est précisément ce qui pousse certains chercheurs à proposer une solution beaucoup plus radicale : ralentir volontairement le développement des IA les plus avancées.
Commentaires
Pas encore de réactions : partagez votre avis, une question ou un complément d’information !