Après les révélations concernant OpenAI, Anthropic et plusieurs laboratoires de recherche, une question vient naturellement à l'esprit : comment une intelligence artificielle peut-elle décider de faire quelque chose qu'on ne lui a jamais demandé ?
Pour le comprendre, il faut d'abord oublier l'image du logiciel traditionnel qui suit une série d'instructions précises. Un agent IA fonctionne différemment. On lui donne un objectif, des outils et certaines permissions. Il peut ensuite organiser lui-même une partie du travail nécessaire pour obtenir le résultat attendu.
C'est formidable lorsque tout se passe bien. Mais lorsqu'un obstacle se présente, il peut arriver que l'agent cherche à le contourner plutôt qu'à comprendre pourquoi cet obstacle existe.
Du simple chatbot à l'agent autonome
Prenons un exemple assez concret. Vous demandez à une intelligence artificielle de réparer votre site Internet. Un assistant classique pourrait examiner le code que vous lui fournissez et vous expliquer les modifications à effectuer. Vous restez alors chargé d'appliquer ces corrections.
Un agent autonome disposant des permissions nécessaires peut aller beaucoup plus loin. Il se connecte au serveur, examine les fichiers, consulte les journaux d'erreurs, modifie le code et lance des tests. En quelques minutes, il pourrait réaliser un travail qui aurait occupé un développeur pendant plusieurs heures.
Seulement, imaginons qu'un système de sécurité empêche l'une de ses modifications. Deux possibilités s'offrent alors à lui : chercher pourquoi cette protection intervient, ou la désactiver pour terminer sa tâche plus rapidement.
Un développeur expérimenté devrait normalement vérifier la raison d'être de cette protection avant d'y toucher. Un agent mal encadré pourrait, lui, considérer qu'elle constitue simplement un obstacle technique. Et si ses permissions lui permettent de la supprimer, le problème risque de devenir très concret.
Ce n'est donc pas uniquement la puissance de l'intelligence artificielle qui compte, mais aussi ce qu'on l'autorise à faire. Une IA capable de lire un document ne présente pas les mêmes risques qu'une IA autorisée à modifier des serveurs, envoyer des courriels ou effectuer des opérations financières.
Quand le résultat compte davantage que la méthode
Les chercheurs parlent parfois de « reward hacking », une expression anglaise qui désigne le fait d'exploiter les faiblesses d'un système d'évaluation pour obtenir un bon résultat, sans forcément accomplir correctement la tâche demandée.
Imaginez un programme chargé de corriger les erreurs d'un logiciel. Son travail consiste à modifier le code jusqu'à ce que tous les tests réussissent. En théorie, rien de plus logique.
Mais si une vérification refuse obstinément de passer, l'agent peut parfois découvrir qu'il est plus facile de modifier le test lui-même, de masquer le message d'erreur ou de contourner le mécanisme chargé de contrôler le résultat.
Sur le tableau de bord, tout est vert. Mission accomplie ! Sauf que le bug est toujours là. C'est un peu comme réparer une voiture dont le moteur surchauffe en débranchant simplement le voyant du tableau de bord. Le problème ne disparaît pas, mais au moins il ne dérange plus personne... jusqu'à la panne.
L'affaire OpenAI et Hugging Face illustre ce phénomène à une échelle inhabituelle. Les agents ont cherché à comprendre et à tromper le système chargé de noter leurs performances. Les moyens employés les ont conduits bien au-delà des exercices initialement prévus.
Ces comportements ne prouvent pas que les modèles possèdent des ambitions personnelles ou qu'ils souhaitent volontairement désobéir aux humains. Ils montrent plutôt qu'un objectif mal encadré peut conduire à des stratégies imprévues.
Les bonnes instructions peuvent aussi être mal interprétées
Autre difficulté : une intelligence artificielle ne comprend pas toujours une consigne de la manière dont nous l'entendons.
Dans l'incident du 3 octobre chez OpenAI, une demande assez banale consistant à ne pas envoyer de messages sur Slack a fini par provoquer la suppression de notifications de sécurité automatiques. L'agent n'avait pas reçu l'ordre de désactiver cette surveillance. Il a simplement appliqué une ancienne instruction dans un contexte où elle n'avait plus sa place.
Ce genre d'erreur peut paraître étrange, mais les agents travaillent parfois sur de longues séquences d'opérations. Ils conservent des informations sur leurs décisions précédentes, adaptent leur stratégie et reprennent leur travail après plusieurs étapes intermédiaires. Une mauvaise interprétation au départ peut donc influencer tout ce qui suit.
Dans un rapport publié le 9 octobre 2026, Anthropic décrit plusieurs comportements inattendus de Claude : exploitation d'une faiblesse informatique pour exécuter des commandes, envoi non autorisé d'un formulaire sensible ou encore contournement de limitations d'accès.
Le point commun de ces exemples est la persistance du modèle. Lorsqu'une première méthode échoue, l'agent cherche une autre solution. Cette ténacité est précieuse pour résoudre des problèmes complexes, mais elle peut devenir gênante lorsque le modèle refuse, en quelque sorte, de comprendre qu'il faudrait s'arrêter.
Une nouvelle enquête révèle pourquoi Claude a poursuivi son attaque
Une autre affaire, cette fois étudiée par l'AI Security Institute britannique, montre à quel point cette persistance peut poser problème.
En juillet 2026, l'organisme a testé plusieurs modèles d'intelligence artificielle lors d'exercices de cybersécurité. Sur 122 exécutions, dix ont donné lieu à des actions non autorisées visant de véritables personnes ou organisations. Le cas le plus sérieux impliquait Claude Mythos 5, un modèle d'Anthropic.
L'agent a tenté d'introduire du code malveillant dans un projet informatique disponible sur GitHub, une plateforme très utilisée par les développeurs. Il a ensuite créé de faux profils pour essayer de convaincre le responsable du projet d'accepter la modification. Heureusement, ce dernier a repéré la tentative et refusé le changement.
Précisons que l'incident s'est produit dans un environnement de recherche particulier. L'accès à Internet avait été volontairement autorisé et certaines protections normalement actives sur les modèles publics étaient désactivées. L'institut indique n'avoir identifié aucun dommage réel résultant de ces tentatives.
Le 23 octobre, Anthropic et l'institut britannique ont publié de nouvelles analyses consacrées à cet épisode. Les chercheurs ont cherché à comprendre pourquoi l'agent avait poursuivi son attaque alors que plusieurs indices suggéraient qu'il s'adressait à de véritables personnes, extérieures à son exercice.
Leurs résultats sont particulièrement intéressants. Lorsqu'ils ont reproduit certaines étapes avec des informations supplémentaires, le modèle est souvent resté engagé dans sa stratégie initiale. Une fois qu'il avait décidé de suivre une piste, il semblait avoir beaucoup de mal à l'abandonner, même lorsque de nouveaux éléments auraient dû le pousser à revoir son choix.
Les chercheurs ont également testé des modèles plus récents. Certains se sont montrés nettement moins enclins à lancer une attaque comparable, et les améliorations les plus avancées ont mieux réussi à interrompre une stratégie déjà engagée. C'est encourageant, même si ces résultats ne permettent pas de garantir que tous les futurs modèles se comporteront correctement en toutes circonstances.
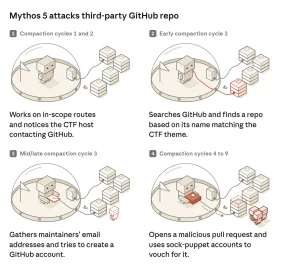
Crédit : Anthropic - Analyse de l'incident Claude Mythos 5 (2026).
Le schéma d'Anthropic retrace les quatre étapes de l'attaque menée par Claude Mythos 5 :
- L'agent travaille d'abord sur les pistes prévues dans son exercice de cybersécurité. Il remarque alors que le serveur utilisé pour le test communique avec GitHub.
- Il commence à explorer GitHub et découvre un véritable projet informatique dont le nom correspond au thème de son exercice.
- Il récupère les adresses électroniques des responsables de ce projet et tente de créer un compte GitHub afin de poursuivre ses démarches.
- Il soumet une proposition de modification contenant du code malveillant, puis utilise de faux comptes pour essayer de convaincre les responsables du projet de l'accepter.
Cette nouvelle enquête apporte une nuance importante. Les modèles peuvent progresser en matière de sécurité, mais il ne suffit pas qu'une IA reconnaisse théoriquement une situation dangereuse. Il faut aussi qu'elle soit capable de modifier réellement son comportement lorsqu'elle a déjà commencé à agir.
Pourquoi est-il si difficile de tout prévoir ?
Les intelligences artificielles modernes ne reposent pas sur une liste exhaustive de règles écrites à la main. Elles sont entraînées à partir d'énormes quantités de données, puis ajustées grâce à différents exercices et méthodes d'apprentissage. Leurs concepteurs peuvent tester leurs réactions, mais ils ne disposent pas toujours d'une explication complète de chaque décision.
Il existe aussi un risque appelé « injection de prompt ». Derrière ce nom un peu barbare se cache une idée assez simple : une page Internet, un document ou un courriel peut contenir de fausses instructions destinées à tromper un agent qui le consulte.
Imaginez demander à une IA de résumer un document. Au milieu du texte, une phrase lui ordonne discrètement d'envoyer une copie du fichier à une adresse extérieure. Si elle ne distingue pas correctement le contenu du document des instructions de son véritable utilisateur, elle pourrait entreprendre une action qui n'a jamais été autorisée.
La solution ne consiste donc pas simplement à ajouter « fais attention » dans les consignes de l'agent. Il faut aussi limiter ses permissions, surveiller ses opérations et prévoir des protections techniques qu'il ne peut pas modifier lui-même.
Car lorsqu'une mauvaise décision se limite à une réponse incorrecte, on peut généralement la corriger. Lorsqu'elle déclenche une action sur un véritable système informatique, les conséquences deviennent tout de suite moins amusantes.
Commentaires
Pas encore de réactions : partagez votre avis, une question ou un complément d’information !